
파이썬으로 데이터의 이상치를 찾는 대표적인 방법인 IQR(사분위수 범위)을 타이타닉 데이터로 실습합니다. 소수점 나이처럼 데이터 특성에 맞지 않는 값을 찾아 numpy로 올림·내림·절사하는 예제와 Z-스코어 방식과의 비교도 함께 정리했습니다.
이상치란 무엇이고 어떻게 찾을까?
우리가 다루는 데이터에는 잘못 입력됐거나 정상이라고 보기 어려운 값이 섞여 있습니다. 이렇게 다른 값들과 현격하게 차이 나는 값이나 패턴을 이상치(outlier)라고 합니다.
이상치를 찾는 방법은 여러 가지이고, 분야나 학회지마다 선호하는 방법도 다릅니다. 어떤 방법을 쓰든 분석 결과를 믿을 수 있으려면 이상치를 먼저 꼼꼼히 살펴야 합니다.
- 단순확인:
- 특정 값(평균, 중앙치, 최빈치)를 기준으로 특정한 값을 다시 계산하여 이상치를 분별, 1표준편차나 2표준편차를 선정하는 등
- 데이터 특성에 맞지 않는 값 찾기, 성별을 1과 2로 코딩했는데, 다른 값이나 소수점 값을 갖는 값
- 히스토그램 확인:
- 데이터를 히스토그램으로 시각화하면 전체 데이터의 분포를 파악할 수 있습니다. 이상치는 전체 분포에서 동떨어진 부분으로 나타날 수 있습니다.
- 상자 수염 그림(Boxplot) 사용:
- 상자 수염 그림은 데이터의 중앙값, 사분위수, 이상치 등을 시각적으로 보여주는 유용한 도구입니다. 상자 수염 그림을 통해 이상치를 식별할 수 있습니다.
- Z-스코어 기반 이상치 탐지:
- Z-스코어는 데이터가 평균에서 얼마나 떨어져 있는지를 측정하는 표준화된 값입니다. 일반적으로 Z-스코어가 특정 임계값을 초과하면 해당 데이터는 이상치로 간주될 수 있습니다.
- IQR (사분위 범위)를 이용한 이상치 탐지:
- 사분위 범위는 데이터의 상위 25%와 하위 25%를 나누는데 사용됩니다. 이상치는 주로 1.5배 이상의 IQR을 벗어나는 값으로 정의될 수 있습니다.
- 시각적 데이터 탐색:
- 데이터를 산점도 등으로 시각화하면 이상치를 눈으로 쉽게 식별할 수 있습니다. 특히, 다른 데이터들과 비교하면서 차이가 큰 데이터를 찾을 수 있습니다.
이 글에서는 이 가운데 가장 널리 쓰이는 IQR 방식과 데이터 특성에 맞지 않는 값을 찾는 단순 확인을 파이썬 코드로 살펴봅니다.
IQR 개념과 통계적 배경
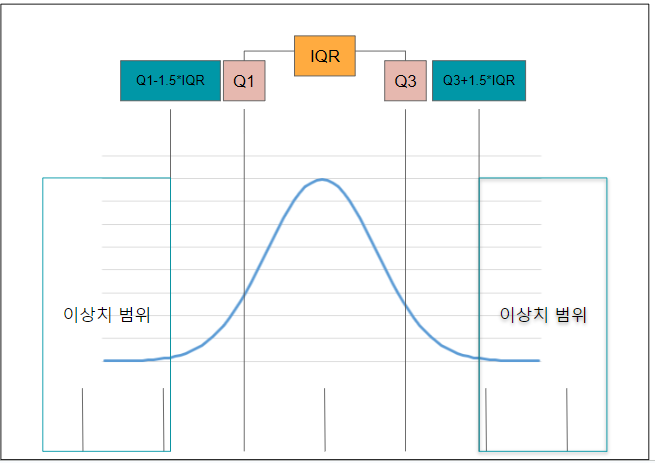
IQR(Interquartile Range, 사분위수 범위)은 데이터의 중간 50% 범위를 나타내는 통계적 측도로, 데이터의 상위 75% 지점과 하위 25% 지점 사이의 범위를 말합니다. IQR은 사분위수만 제대로 이해한다면 어렵지 않게 활용할 수 있습니다. 사분위수는 전체 데이터를 25%씩 4등분한 것을 의미합니다.
| Q1 | 25% |
| Q2 | 50% |
| Q3 | 75% |
| Q4 | 100% |
이 중 25%에서 75%에 해당하는 범위가 Q1부터 Q3까지에 속합니다. Q3에서 Q1을 빼는 연산을 수행하면 75%에 해당하는 값에서 25%에 해당하는 값을 빼게 되는데, 이것이 기준점이 되어 데이터의 중앙 50%에 속하는 특정 범위를 나타내게 됩니다. 데이터를 정리하고 요약하는 수많은 통계적 방법 중 이러한 분포 확인 방식이 널리 쓰이는 이유는 극단적인 값에 휘둘리지 않고 데이터의 밀집 구간을 파악하기 좋기 때문입니다.
중앙치를 기준으로 데이터의 분포 확률과 이상치를 찾는 방법 중 대표적인 것이 바로 IQR이며, 이 IQR은 제3사분위수와 제1사분위수의 차이를 계산하여 특정 경계값을 뽑아내는 데 활용됩니다. 여기서 실무적으로 가장 중요한 포인트는 Q1 – 1.5 * IQR 값과 Q3 + 1.5 * IQR 값을 구하는 것입니다.
앞서 구한 IQR 내의 데이터는 정상적인 분포의 범주를 뜻하는 값이 될 것입니다. 이 Q1과 Q3의 범위를 벗어나는 데이터 중 IQR(정상값으로 여겨지는 값의 폭)의 1.5배를 초과하거나 미달하는 값을 이상치(Outlier)로 판정하는 것입니다.
핵심 키워드
- IQR = Q3 – Q1
- 기준은 중앙치 및 사분위수
- Q1 = 25% 지점 (제1사분위수)
- Q3 = 75% 지점 (제3사분위수)
- 이상치의 범위 기준
- Q1 – 1.5 * IQR 이하 (하위 경계)
- Q3 + 1.5 * IQR 이상 (상위 경계)
IQR-1.5는 통계적 상자그림(Box Plot)에서 이상치를 판별하는 표준적인 기준으로 널리 쓰입니다. IQR-1.5를 사용하면 데이터의 분포에서 크게 벗어난 값들을 객관적으로 정의할 수 있습니다. 이상치 판별 프로세스는 먼저 데이터의 1사분위수(Q1)와 3사분위수(Q3)를 구하고, IQR = Q3 – Q1을 계산한 뒤, 하위 경계(lower bound)와 상위 경계(upper bound)를 산출하는 순서로 진행됩니다. 데이터셋에서 하위 경계보다 작거나 상위 경계보다 큰 값들은 특이값이거나 수집 과정의 오류일 수 있으므로 정밀한 검토가 필요합니다.
데이터 불러오기 및 실무 환경 설정
파이썬을 통해 IQR을 계산하고 이상치를 탐색하려면 먼저 데이터 처리 라이브러리인 pandas와 수치 연산 라이브러리인 numpy를 불러와야 합니다. 실무 환경이나 데이터 분석 경진대회 등에서는 주로 CSV 파일을 읽어와 데이터프레임 형태로 적재한 뒤 분석을 시작합니다.
import pandas as pd
import numpy as np
df = pd.read_csv('../input/titanic/train.csv')
위 코드에서 파일 경로(‘../input/titanic/train.csv’) 부분은 분석가가 현재 파일을 저장하고 있는 로컬 경로 혹은 서버 상의 디렉토리 환경에 맞추어 자유롭게 수정하여 적용하면 됩니다.
탐색적 데이터 분석 (EDA)
데이터를 본격적으로 가공하기 전, 데이터프레임의 구조와 결측치 현황을 파악하는 탐색적 데이터 분석(EDA) 과정을 거쳐야 합니다. 아래의 코드를 실행하여 데이터의 형태와 상위 행들을 먼저 살펴봅니다.
print(df.shape)
print(df.head())
print(df.isnull().sum())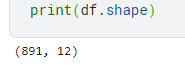
shape 속성은 데이터프레임의 행과 열의 크기를 튜플 형태로 간단하게 보여줍니다. 위 타이타닉 데이터셋의 크기는 891 행 × 12 열로 구성되어 있습니다.
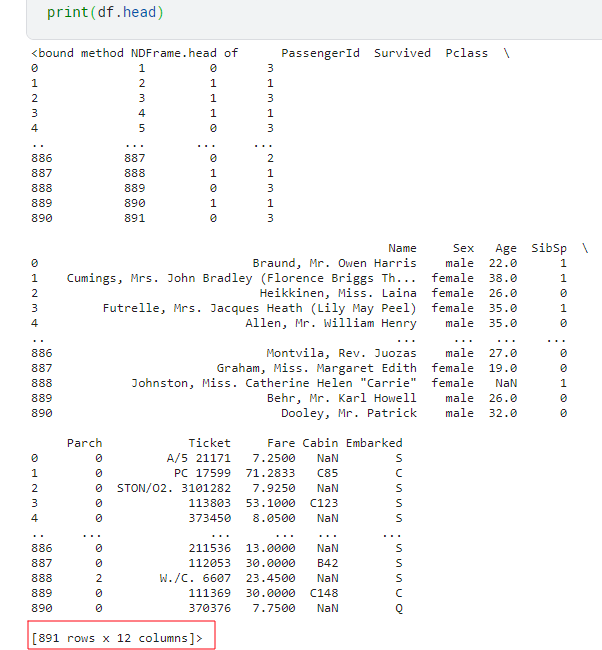
head 메서드는 데이터의 상위 행들을 출력하여 각 열에 어떤 형태의 데이터가 담겨 있는지 직관적으로 파악할 수 있게 돕습니다. 타이타닉 데이터셋의 주요 변수 구성은 다음과 같습니다.
- ‘PassengerId’: 각 승객의 고유 식별자
- ‘Survived’: 생존 여부 (0: 사망, 1: 생존)
- ‘Pclass’: 승객의 객실 등급 (1, 2, 3)
- ‘Name’: 승객의 이름
- ‘Sex’: 승객의 성별 (male 또는 female)
- ‘Age’: 승객의 나이
- ‘SibSp’: 함께 탑승한 형제자매 또는 배우자의 수
- ‘Parch’: 함께 탑승한 부모 또는 자녀의 수
- ‘Ticket’: 티켓 번호
- ‘Fare’: 지불한 운임
- ‘Cabin’: 객실 번호
- ‘Embarked’: 탑승 항구 (C, Q, S)
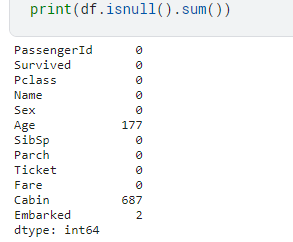
isnull().sum() 코드는 각 열에 존재하는 결측값(Missing Value)의 개수를 정확하게 계산하고 출력합니다. 결측치 분석 결과는 다음과 같습니다.
- ‘Age’ 열에는 177개의 결측값이 있습니다.
- ‘Cabin’ 열에는 687개의 결측값이 있습니다.
- ‘Embarked’ 열에는 2개의 결측값이 있습니다.
IQR 분석 및 경계값 계산
데이터의 구조를 파악했다면, 이제 특정 수치형 변수(여기서는 승객이 지불한 운임인 ‘Fare’ 열)를 대상으로 IQR을 구하고 이상치 기준이 되는 상하한선을 계산해 볼 수 있습니다. IQR은 제3사분위수와 제1사분위수의 차이로 계산됩니다.
# IQR 구하기
Q1 = np.percentile(df['Fare'], 25)
Q3 = np.percentile(df['Fare'], 75)
IQR = Q3 - Q1
minimum = Q1 - 1.5 * IQR
maximum = Q3 + 1.5 * IQR
print(minimum)
print(maximum)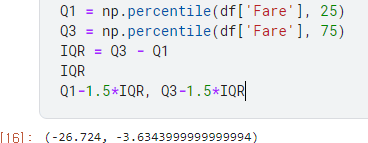
이 코드를 통해 산출된 minimum과 maximum 값은 우리가 실제로 분석하고자 하는 ‘Fare’ 변수에서 정상 범위를 결정하고 이상치를 걸러내기 위한 기준점이 됩니다.
이상치 개수 구하기
기준 경계값을 구했으므로, 이제 전체 데이터셋에서 이 기준을 벗어나는 하한 미만의 값과 상한 초과 값의 개수를 각각 추출하여 확인할 수 있습니다. 대규모 데이터 분석 실무에서는 필터링 조건에 부합하는 데이터의 건수를 파악하는 것이 데이터 정제 작업의 핵심 단계입니다.
out_low = df[df['Fare'] < minimum]
out_high = df[df['Fare'] > maximum]
print(out_low.shape[0])
print(out_high.shape[0])

print(out_high.shape[0] + out_low.shape[0])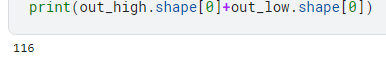
실제 분석 업무나 빅데이터 분석기사 실기 시험 등에서는 전체 이상치의 개수를 정확히 집계하는 요령을 알아두는 것이 매우 유용합니다. 데이터프레임의 행 개수나 크기를 확인할 때는 .shape[0] 속성을 활용하거나 파이썬 내장 함수인 len()을 함께 활용할 수도 있습니다. 위 예제 코드를 통해 하위 이상치와 상위 이상치의 개수 및 전체 이상치 총합을 명확하게 파악할 수 있습니다.
단순 확인: 데이터 특성에 맞지 않는 값 찾기
성별을 1과 2로 코딩했는데 3이나 1.5 같은 값이 섞여 있다면, 그 값은 데이터 특성에 맞지 않는 이상치입니다. 파이썬으로 이런 값을 쉽게 찾을 수 있습니다. 여기서는 캐글의 Big Data Certification KR 문제로 나이 데이터를 살펴봅니다.
출처 : https://www.kaggle.com/datasets/agileteam/bigdatacertificationkr
문제는 “주어진 데이터에서 이상치(소수점 나이)를 찾고 올림, 내림, 버림(절사)했을때 3가지 모두 이상치 ‘age’ 평균을 구한 다음 모두 더하여 출력하시오” 입니다.
알아야하는 것
- 패키지 불러오기
- 데이터 불러오기
- 데이터 추출
- Numpy 절삭 메소드 종류
- 합계
1. 패키지 불러오기 + 2. 데이터 불러오기
모든 분석의 기본은 패키지를 불러오는 것입니다. csv파일을 불러오기 위해서라도 pandas를 써야하죠
import pandas as pd
import numpy as np
df = pd.read_csv('../input/bigdatacertificationkr/basic1.csv') # 이부분이 데이터를 불러오는 부분
3. 데이터 추출
먼저, 소수점을 가진 데이터들을 찾아야합니다.
소수점 데이터는 찾을 수 있는 방법이 많습니다. 일단 1로 나눴을 때 나머지가 0이 아닌 것. 위 캐글에서 KIM TAE HEON님이 설명한 방법은 원래 데이터(소수점이 있는 데이터)에서 버림한 데이터(소수점이 없는 데이터)를 빼서, 결과가 0이 아닌 값을 찾는 것입니다.
여기서는 % 연산자로 1로 나눈 나머지가 0이 아닌 데이터를 뽑아 보겠습니다.
이상치를 뜻하는 outlier를 변수명으로 쓰면 outlier = df[df['age'] % 1 != 0]처럼 쓸 수 있습니다.
여기서 주목해야 할 점은 df[‘age’]가 df[]에 또 묶이는 것입니다. 파이썬에서 특정 열을 불러 올 때 많이 혼동될 수 있어 짚고 넘어가고자합니다. 내용을 해석하자면, df(전체데이터) 중 age열의 데이터가 1로 나눴을 때 나머지가 0이 아닌 것을 df(전체데이터)에서 추출하자는 것입니다.
outlier = df[df['age'] % 1 != 0]
print(outlier.count())
4. Numpy 절삭 메소드 종류
올림은 RU, 내림은 RD, 절사는 TR로 변수명을 정했습니다.
이때, 활용되는 메소드는 numpy의 메소드들이며 다음과 같습니다.
- ceil : 올림
- floor : 버림
- trunc : 절사
- mean : 평균 계산
ru = np.ceil(outlier['age']).mean()
rd = np.floor(outlier['age']).mean()
tr = np.trunc(outlier['age']).mean()

ru, rd, tr
5. 합계
합계는 간단합니다. 단순하게 하면 위 변수들을 모두 더해서 print문에 넣으면 됩니다.
print(ru+rd+tr)이상치 처리 방법 비교 및 실무 가이드
데이터 분석 실무에서 이상치를 마주했을 때 단순히 제거하는 것만이 정답은 아닙니다. 데이터의 특성과 분석 목적에 따라 적절한 조치 방법을 선택해야 하며, 아래의 비교표를 참고하여 상황에 맞는 전략을 수립하는 것이 좋습니다.
| 구분 | Z-스코어 방식 | IQR (사분위 범위) 방식 |
|---|---|---|
| 기본 가정 | 데이터가 정규 분포를 따른다고 가정 | 비정규 분포나 치우친 데이터에도 적용 가능 |
| 임계값 기준 | 보통 절대값이 3을 초과하는 경우 | Q1 – 1.5 * IQR 미만 또는 Q3 + 1.5 * IQR 초과 |
| 장점 | 구현이 직관적이며 표준화된 수치 제공 | 극단적인 최솟값/최댓값의 영향에 비교적 강건함 |
| 단점 | 샘플 크기가 작거나 비정규 분포일 때 오류 발생 가능 | 데이터 특성에 따라 임계값 조정이 필요할 수 있음 |
FAQ 및 실무 체크포인트
Q1. 1.5 대신 다른 상수를 곱해서 이상치를 판별해도 되나요?
네, 가능합니다. 일반적인 통계 분석이나 상자그림에서는 1.5를 곱하는 것이 표준이지만, 데이터의 분포가 매우 치우쳐 있거나 보수적인 정제가 필요한 경우 3.0 등의 다른 계수를 적용하여 극단적인 이상치(Extreme Outlier)만을 별도로 분리해낼 수도 있습니다.
Q2. 결측치가 포함된 열에 np.percentile을 적용하면 어떻게 되나요?
np.percentile은 결측치(NaN)가 하나라도 있으면 결과가 nan으로 나옵니다. 결측치를 빼고 계산하려면 np.nanpercentile()을 쓰거나, 결측치를 알아서 건너뛰는 판다스 quantile() 메서드를 쓰면 됩니다.
Q3. 이상치를 무조건 제거하는 것이 좋은가요?
아닙니다. 데이터 입력 오류나 시스템 결함으로 인한 이상치는 제거하거나 대체하는 것이 맞지만, 드문 확률로 발생하는 실제 유효한 극단값(예: 초고액 자산가의 소비 데이터)일 경우 비즈니스 인사이트를 도출하는 중요한 단서가 될 수 있습니다. 따라서 도메인 지식을 바탕으로 신중하게 판단해야 합니다.
Q4. 파이썬 분석 시 결측치와 이상치의 차이는 무엇인가요?
결측치는 데이터가 아예 비어 있는 상태(NaN, Null 등)를 의미하며, 이상치는 값은 존재하지만 정상적인 범위를 크게 벗어난 비정상적인 값을 의미합니다. 두 가지 모두 전처리 단계에서 각각 적절한 결측치 대치법과 이상치 필터링 기법을 적용해 주어야 합니다.