
파이썬과 판다스(Pandas), 넘파이(Numpy) 라이브러리를 활용하여 데이터 분석에서 필수적인 사분위수 범위(IQR) 기반의 이상치 탐지 기법을 실무 코드와 함께 상세히 다룹니다. 타이타닉 데이터셋을 예제로 불러와 탐색적 데이터 분석(EDA)부터 하위/상위 경계값 설정 및 이상치 개수 추출까지 전체 파이프라인을 학습합니다.
IQR 개념과 통계적 배경
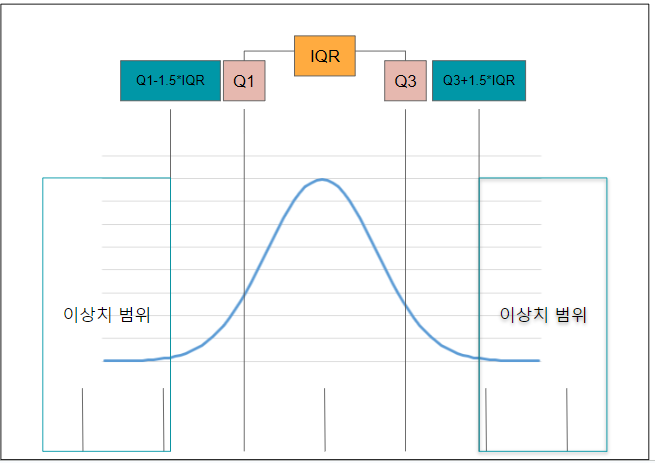
IQR(Interquartile Range, 사분위수 범위)은 데이터의 중간 50% 범위를 나타내는 통계적 측도로, 데이터의 상위 75% 지점과 하위 25% 지점 사이의 범위를 말합니다. IQR은 사분위수만 제대로 이해한다면 어렵지 않게 활용할 수 있습니다. 사분위수는 전체 데이터를 25%씩 4등분한 것을 의미합니다.
| Q1 | 25% |
| Q2 | 50% |
| Q3 | 75% |
| Q4 | 100% |
이 중 25%에서 75%에 해당하는 범위가 Q1부터 Q3까지에 속합니다. Q3에서 Q1을 빼는 연산을 수행하면 75%에 해당하는 값에서 25%에 해당하는 값을 빼게 되는데, 이것이 기준점이 되어 데이터의 중앙 50%에 속하는 특정 범위를 나타내게 됩니다. 데이터를 정리하고 요약하는 수많은 통계적 방법 중 이러한 분포 확인 방식이 널리 쓰이는 이유는 극단적인 값에 휘둘리지 않고 데이터의 밀집 구간을 파악하기 좋기 때문입니다.
중앙치를 기준으로 데이터의 분포 확률과 이상치를 찾는 방법 중 대표적인 것이 바로 IQR이며, 이 IQR은 제3사분위수와 제1사분위수의 차이를 계산하여 특정 경계값을 뽑아내는 데 활용됩니다. 여기서 실무적으로 가장 중요한 포인트는 Q1 – 1.5 * IQR 값과 Q3 + 1.5 * IQR 값을 구하는 것입니다. 앞서 구한 IQR 내의 데이터는 정상적인 분포의 범주를 뜻하는 값이 될 것입니다. 이 Q1과 Q3의 범위를 벗어나는 데이터 중 IQR(정상값으로 여겨지는 값의 폭)의 1.5배를 초과하거나 미달하는 값을 이상치(Outlier)로 판정하는 것입니다.
핵심 키워드
- IQR = Q3 – Q1
- 기준은 중앙치 및 사분위수
- Q1 = 25% 지점 (제1사분위수)
- Q3 = 75% 지점 (제3사분위수)
- 이상치의 범위 기준
- Q1 – 1.5 * IQR 이하 (하위 경계)
- Q3 + 1.5 * IQR 이상 (상위 경계)
IQR-1.5는 통계적 상자그림(Box Plot)에서 이상치를 판별하는 표준적인 기준으로 널리 쓰입니다. IQR-1.5를 사용하면 데이터의 분포에서 크게 벗어난 값들을 객관적으로 정의할 수 있습니다. 이상치 판별 프로세스는 먼저 데이터의 1사분위수(Q1)와 3사분위수(Q3)를 구하고, IQR = Q3 – Q1을 계산한 뒤, 하위 경계(lower bound)와 상위 경계(upper bound)를 산출하는 순서로 진행됩니다. 데이터셋에서 하위 경계보다 작거나 상위 경계보다 큰 값들은 특이값이거나 수집 과정의 오류일 수 있으므로 정밀한 검토가 필요합니다.
데이터 불러오기 및 실무 환경 설정
파이썬을 통해 IQR을 계산하고 이상치를 탐색하려면 먼저 데이터 처리 라이브러리인 pandas와 수치 연산 라이브러리인 numpy를 불러와야 합니다. 실무 환경이나 데이터 분석 경진대회 등에서는 주로 CSV 파일을 읽어와 데이터프레임 형태로 적재한 뒤 분석을 시작합니다.
import pandas as pd
import numpy as np
df = pd.read_csv('../input/titanic/train.csv')
위 코드에서 파일 경로(‘../input/titanic/train.csv’) 부분은 분석가가 현재 파일을 저장하고 있는 로컬 경로 혹은 서버 상의 디렉토리 환경에 맞추어 자유롭게 수정하여 적용하면 됩니다.
탐색적 데이터 분석 (EDA)
데이터를 본격적으로 가공하기 전, 데이터프레임의 구조와 결측치 현황을 파악하는 탐색적 데이터 분석(EDA) 과정을 거쳐야 합니다. 아래의 코드를 실행하여 데이터의 형태와 상위 행들을 먼저 살펴봅니다.
print(df.shape)
print(df.head)
print(df.isnull().sum())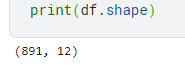
shape 속성은 데이터프레임의 행과 열의 크기를 튜플 형태로 간단하게 보여줍니다. 위 타이타닉 데이터셋의 크기는 891 행 × 12 열로 구성되어 있습니다.
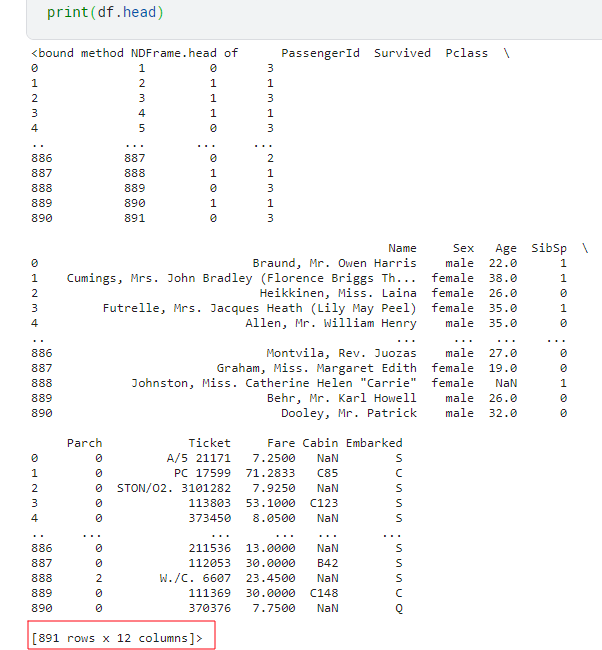
head 메서드는 데이터의 상위 행들을 출력하여 각 열에 어떤 형태의 데이터가 담겨 있는지 직관적으로 파악할 수 있게 돕습니다. 타이타닉 데이터셋의 주요 변수 구성은 다음과 같습니다.
- ‘PassengerId’: 각 승객의 고유 식별자
- ‘Survived’: 생존 여부 (0: 사망, 1: 생존)
- ‘Pclass’: 승객의 객실 등급 (1, 2, 3)
- ‘Name’: 승객의 이름
- ‘Sex’: 승객의 성별 (male 또는 female)
- ‘Age’: 승객의 나이
- ‘SibSp’: 함께 탑승한 형제자매 또는 배우자의 수
- ‘Parch’: 함께 탑승한 부모 또는 자녀의 수
- ‘Ticket’: 티켓 번호
- ‘Fare’: 지불한 운임
- ‘Cabin’: 객실 번호
- ‘Embarked’: 탑승 항구 (C, Q, S)
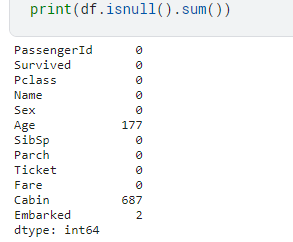
isnull().sum() 코드는 각 열에 존재하는 결측값(Missing Value)의 개수를 정확하게 계산하고 출력합니다. 결측치 분석 결과는 다음과 같습니다.
- ‘Age’ 열에는 177개의 결측값이 있습니다.
- ‘Cabin’ 열에는 687개의 결측값이 있습니다.
- ‘Embarked’ 열에는 2개의 결측값이 있습니다.
IQR 분석 및 경계값 계산
데이터의 구조를 파악했다면, 이제 특정 수치형 변수(여기서는 승객이 지불한 운임인 ‘Fare’ 열)를 대상으로 IQR을 구하고 이상치 기준이 되는 상하한선을 계산해 볼 수 있습니다. IQR은 제3사분위수와 제1사분위수의 차이로 계산됩니다.
# IQR 구하기
Q1 = np.percentile(df['Fare'], 25)
Q3 = np.percentile(df['Fare'], 75)
IQR = Q3 - Q1
minimum = Q1 - 1.5 * IQR
maximum = Q3 + 1.5 * IQR
print(minimum)
print(maximum)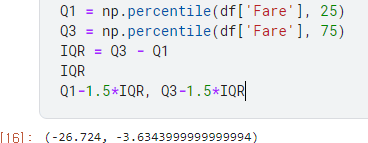
이 코드를 통해 산출된 minimum과 maximum 값은 우리가 실제로 분석하고자 하는 ‘Fare’ 변수에서 정상 범위를 결정하고 이상치를 걸러내기 위한 기준점이 됩니다.
이상치 개수 구하기
기준 경계값을 구했으므로, 이제 전체 데이터셋에서 이 기준을 벗어나는 하한 미만의 값과 상한 초과 값의 개수를 각각 추출하여 확인할 수 있습니다. 대규모 데이터 분석 실무에서는 필터링 조건에 부합하는 데이터의 건수를 파악하는 것이 데이터 정제 작업의 핵심 단계입니다.
out_low = df[df['Fare'] < minimum]
out_high = df[df['Fare'] > maximum]
print(out_low.shape[0])
print(out_high.shape[0])

print(out_high.shape[0] + out_low.shape[0])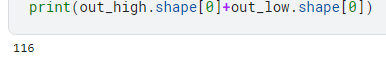
실제 분석 업무나 빅데이터 분석기사 실기 시험 등에서는 전체 이상치의 개수를 정확히 집계하는 요령을 알아두는 것이 매우 유용합니다. 데이터프레임의 행 개수나 크기를 확인할 때는 .shape[0] 속성을 활용하거나 파이썬 내장 함수인 len()을 함께 활용할 수도 있습니다. 위 예제 코드를 통해 하위 이상치와 상위 이상치의 개수 및 전체 이상치 총합을 명확하게 파악할 수 있습니다.
FAQ 및 실무 체크포인트
Q1. 1.5 대신 다른 상수를 곱해서 이상치를 판별해도 되나요?
네, 가능합니다. 일반적인 통계 분석이나 상자그림에서는 1.5를 곱하는 것이 표준이지만, 데이터의 분포가 매우 치우쳐 있거나 보수적인 정제가 필요한 경우 3.0 등의 다른 계수를 적용하여 극단적인 이상치(Extreme Outlier)만을 별도로 분리해낼 수도 있습니다.
Q2. 결측치가 포함된 열에 np.percentile을 적용하면 어떻게 되나요?
판다스의 기본 메서드와 달리 numpy의 퍼센타일 함수는 결측치(NaN)가 포함되어 있을 경우 정상적인 연산을 수행하지 못하고 에러를 발생시킬 수 있습니다. 따라서 실무에서 사분위수를 구할 때는 사전에 dropna() 등을 통해 결측치를 제외하거나 판다스 내장 quantile() 메서드를 활용하는 것을 권장합니다.